음성 AI에서 사용자는 모델의 이름보다 첫 문장과 첫 대답의 속도를 먼저 기억합니다. 말의 정확도, 목소리의 일관성, 기다리는 시간은 모두 서비스가 얼마나 믿을 만하게 느껴지는지에 영향을 줍니다.
Google은 9월 22일 Gemini 3.8 Flash TTS와 Flash‑Lite TTS의 정식 출시를 변경 로그에 공개했습니다. 개발자가 서비스 목적에 맞는 음성 생성 모델을 선택할 수 있는 범위가 넓어진 것입니다.
Gemini 3.8 Flash TTS 정식 출시
텍스트 응답은 사용자가 눈으로 훑으며 속도를 조절할 수 있습니다. 반면 음성 응답은 말의 속도와 억양, 중간 침묵까지 제품 경험이 됩니다. 그래서 같은 정보라도 어떤 목소리로 전달되는지에 따라 서비스의 성격이 크게 달라집니다.
TTS*모델의 정식 출시는 음성 기능이 실험 단계에서 운영 단계로 옮겨가고 있다는 신호입니다. 제품은 더 많은 목소리를 제공하는 데서 멈추지 않고, 사용자가 언제 듣고 언제 읽을지 선택할 수 있도록 맥락을 설계해야 합니다.
TTS는 안내 방송, 음성 비서, 고객 응대처럼 화면을 보기 어려운 상황에서 쓰입니다. 서비스에는 재생 속도 조절과 일시 정지, 텍스트 확인 기능이 함께 필요합니다.
Flash와 저비용형 Flash‑Lite로 구분
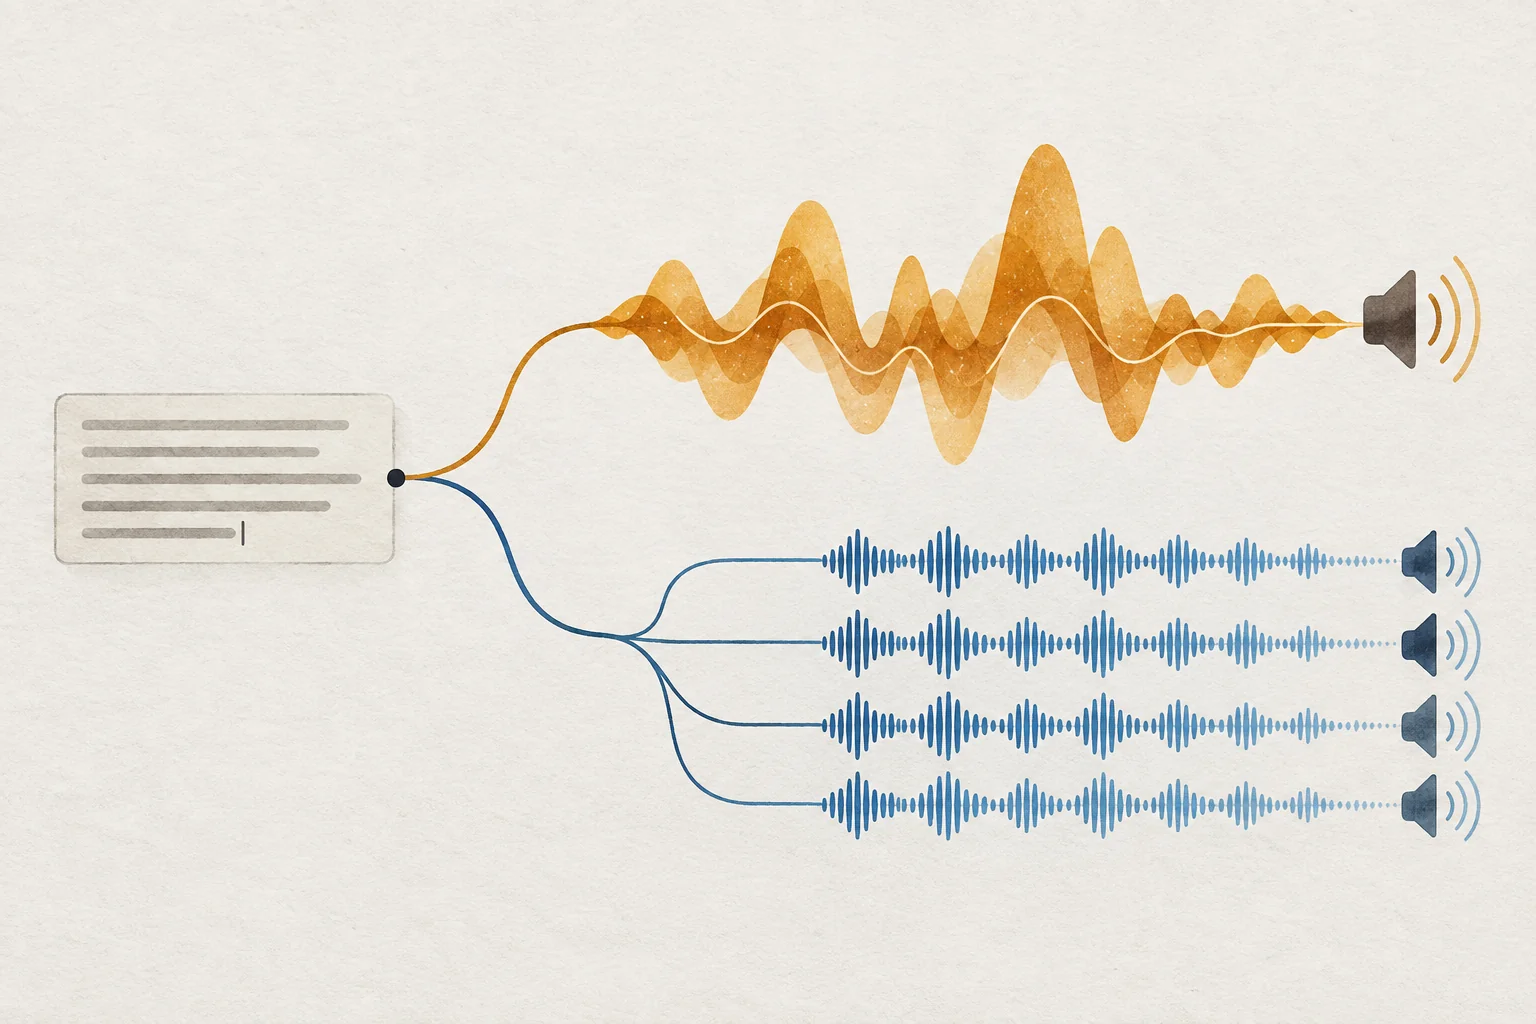
Flash와 Flash‑Lite라는 구분은 단순한 성능표가 아닙니다. 빠른 상호작용이 필요한 대화와 대량으로 안내 음성을 생성하는 작업은 지연 시간과 비용의 조건이 다릅니다.
음성을 제품에 넣을 때는 모델 선택보다 먼저 사용자가 소리를 켤 수 있는지, 조용한 환경에서 대체 텍스트를 볼 수 있는지, 잘못 들었을 때 되돌아갈 수 있는지를 정해야 합니다. 음성이 유용한 경우와 방해가 되는 경우는 기술 성능만으로 나뉘지 않습니다.
Flash는 응답 품질과 속도가 중요한 대화형 서비스, Flash‑Lite는 대량 음성 생성처럼 비용을 줄여야 하는 작업에 선택할 수 있습니다.
음성 재생과 텍스트 확인 기능도 필요
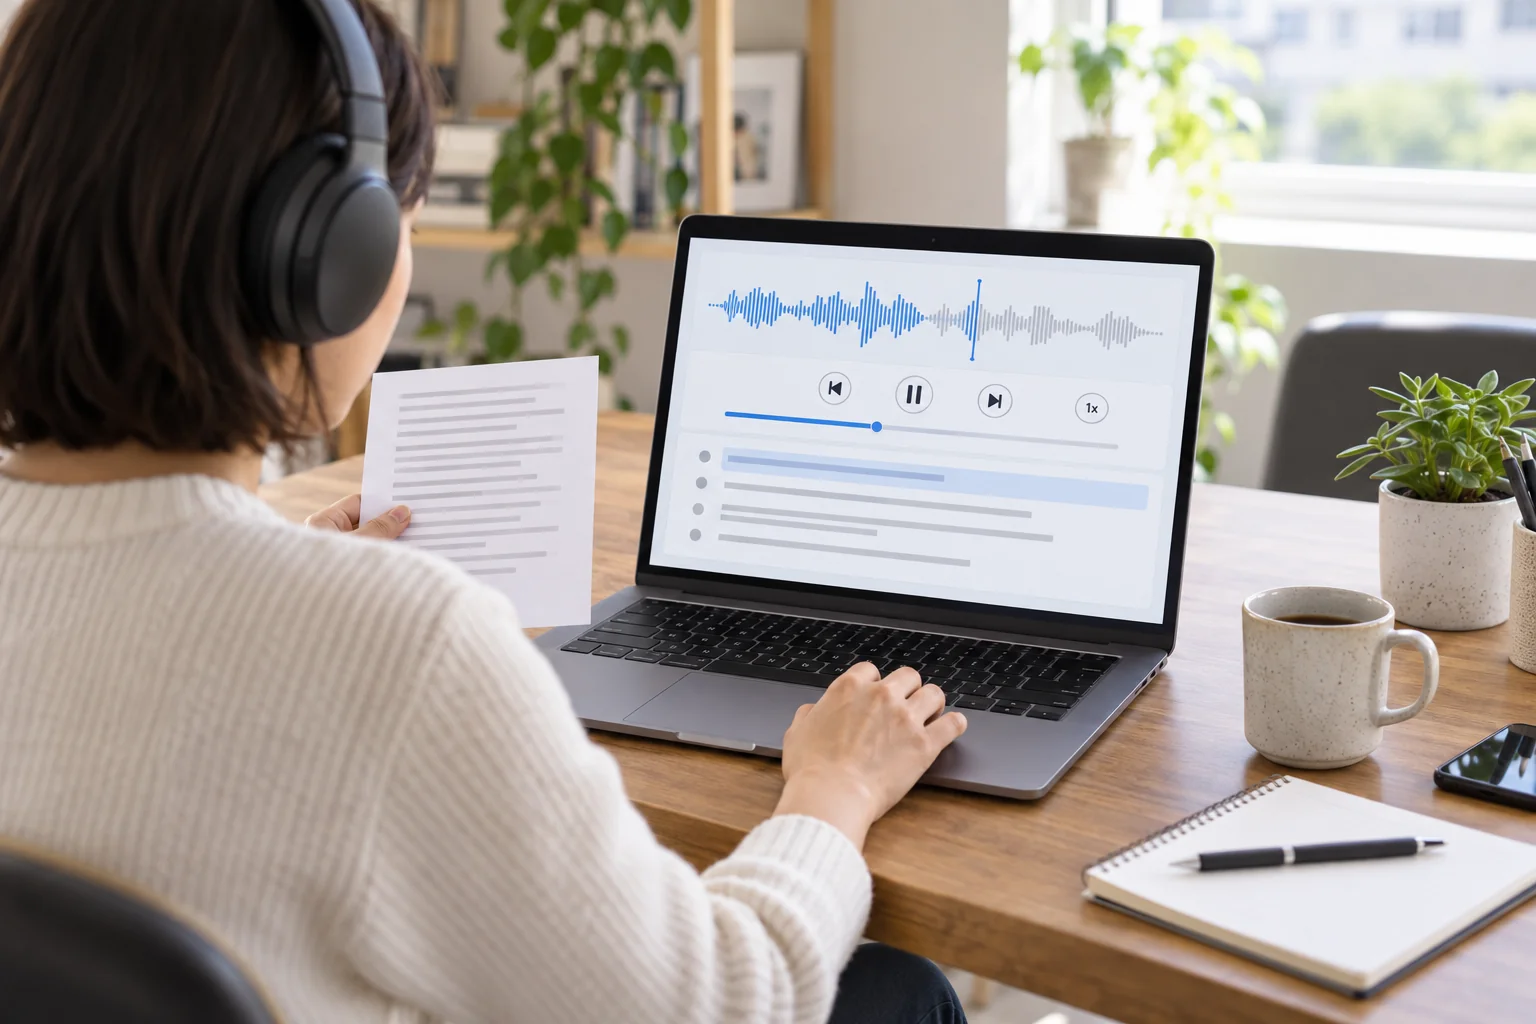
사람과 비슷한 목소리는 대화의 부담을 줄일 수 있지만, 시스템의 정체를 흐리게 해서는 안 됩니다. AI가 말하고 있다는 표시와 재생·중단·텍스트 전환의 권한은 음성 경험의 기본 요소가 됩니다.
이름·주소·금액처럼 오해하기 쉬운 정보는 화면의 텍스트로 다시 확인할 수 있어야 합니다. 대화 기록과 재생 제어가 있으면 잘못 들은 부분을 바로 검토할 수 있습니다.
음성 기능을 평가할 때는 데모의 자연스러움과 실제 사용의 반복성을 구분해야 합니다. 이전 답변을 다시 듣고 잘못 인식한 내용을 고치며 필요할 때 텍스트로 돌아갈 수 있어야, 음성은 지속적으로 쓸 수 있는 기능이 됩니다.

D.Flick Note
Google은 Gemini 3.8 TTS를 Flash와 Flash‑Lite 두 모델로 출시했습니다. 개발자는 응답 품질과 비용 중 우선순위에 따라 모델을 선택하고, 사용자에게는 재생 제어와 텍스트 확인 수단을 제공해야 합니다.
References
- TTS: Text-to-Speech의 약자로, 텍스트를 사람이 들을 수 있는 음성으로 변환하는 기술입니다.