마이크로소프트 CEO 사티아 나델라가 10월 10일 AI 모델을 기업 내부의 위험 요소처럼 다뤄야 한다는 제안을 내놨습니다. AI가 이미 해킹됐다는 폭로가 아니라, 안전 설계 단계부터 모델을 완전히 신뢰하지 않는다는 가정으로 출발하자는 주장입니다.
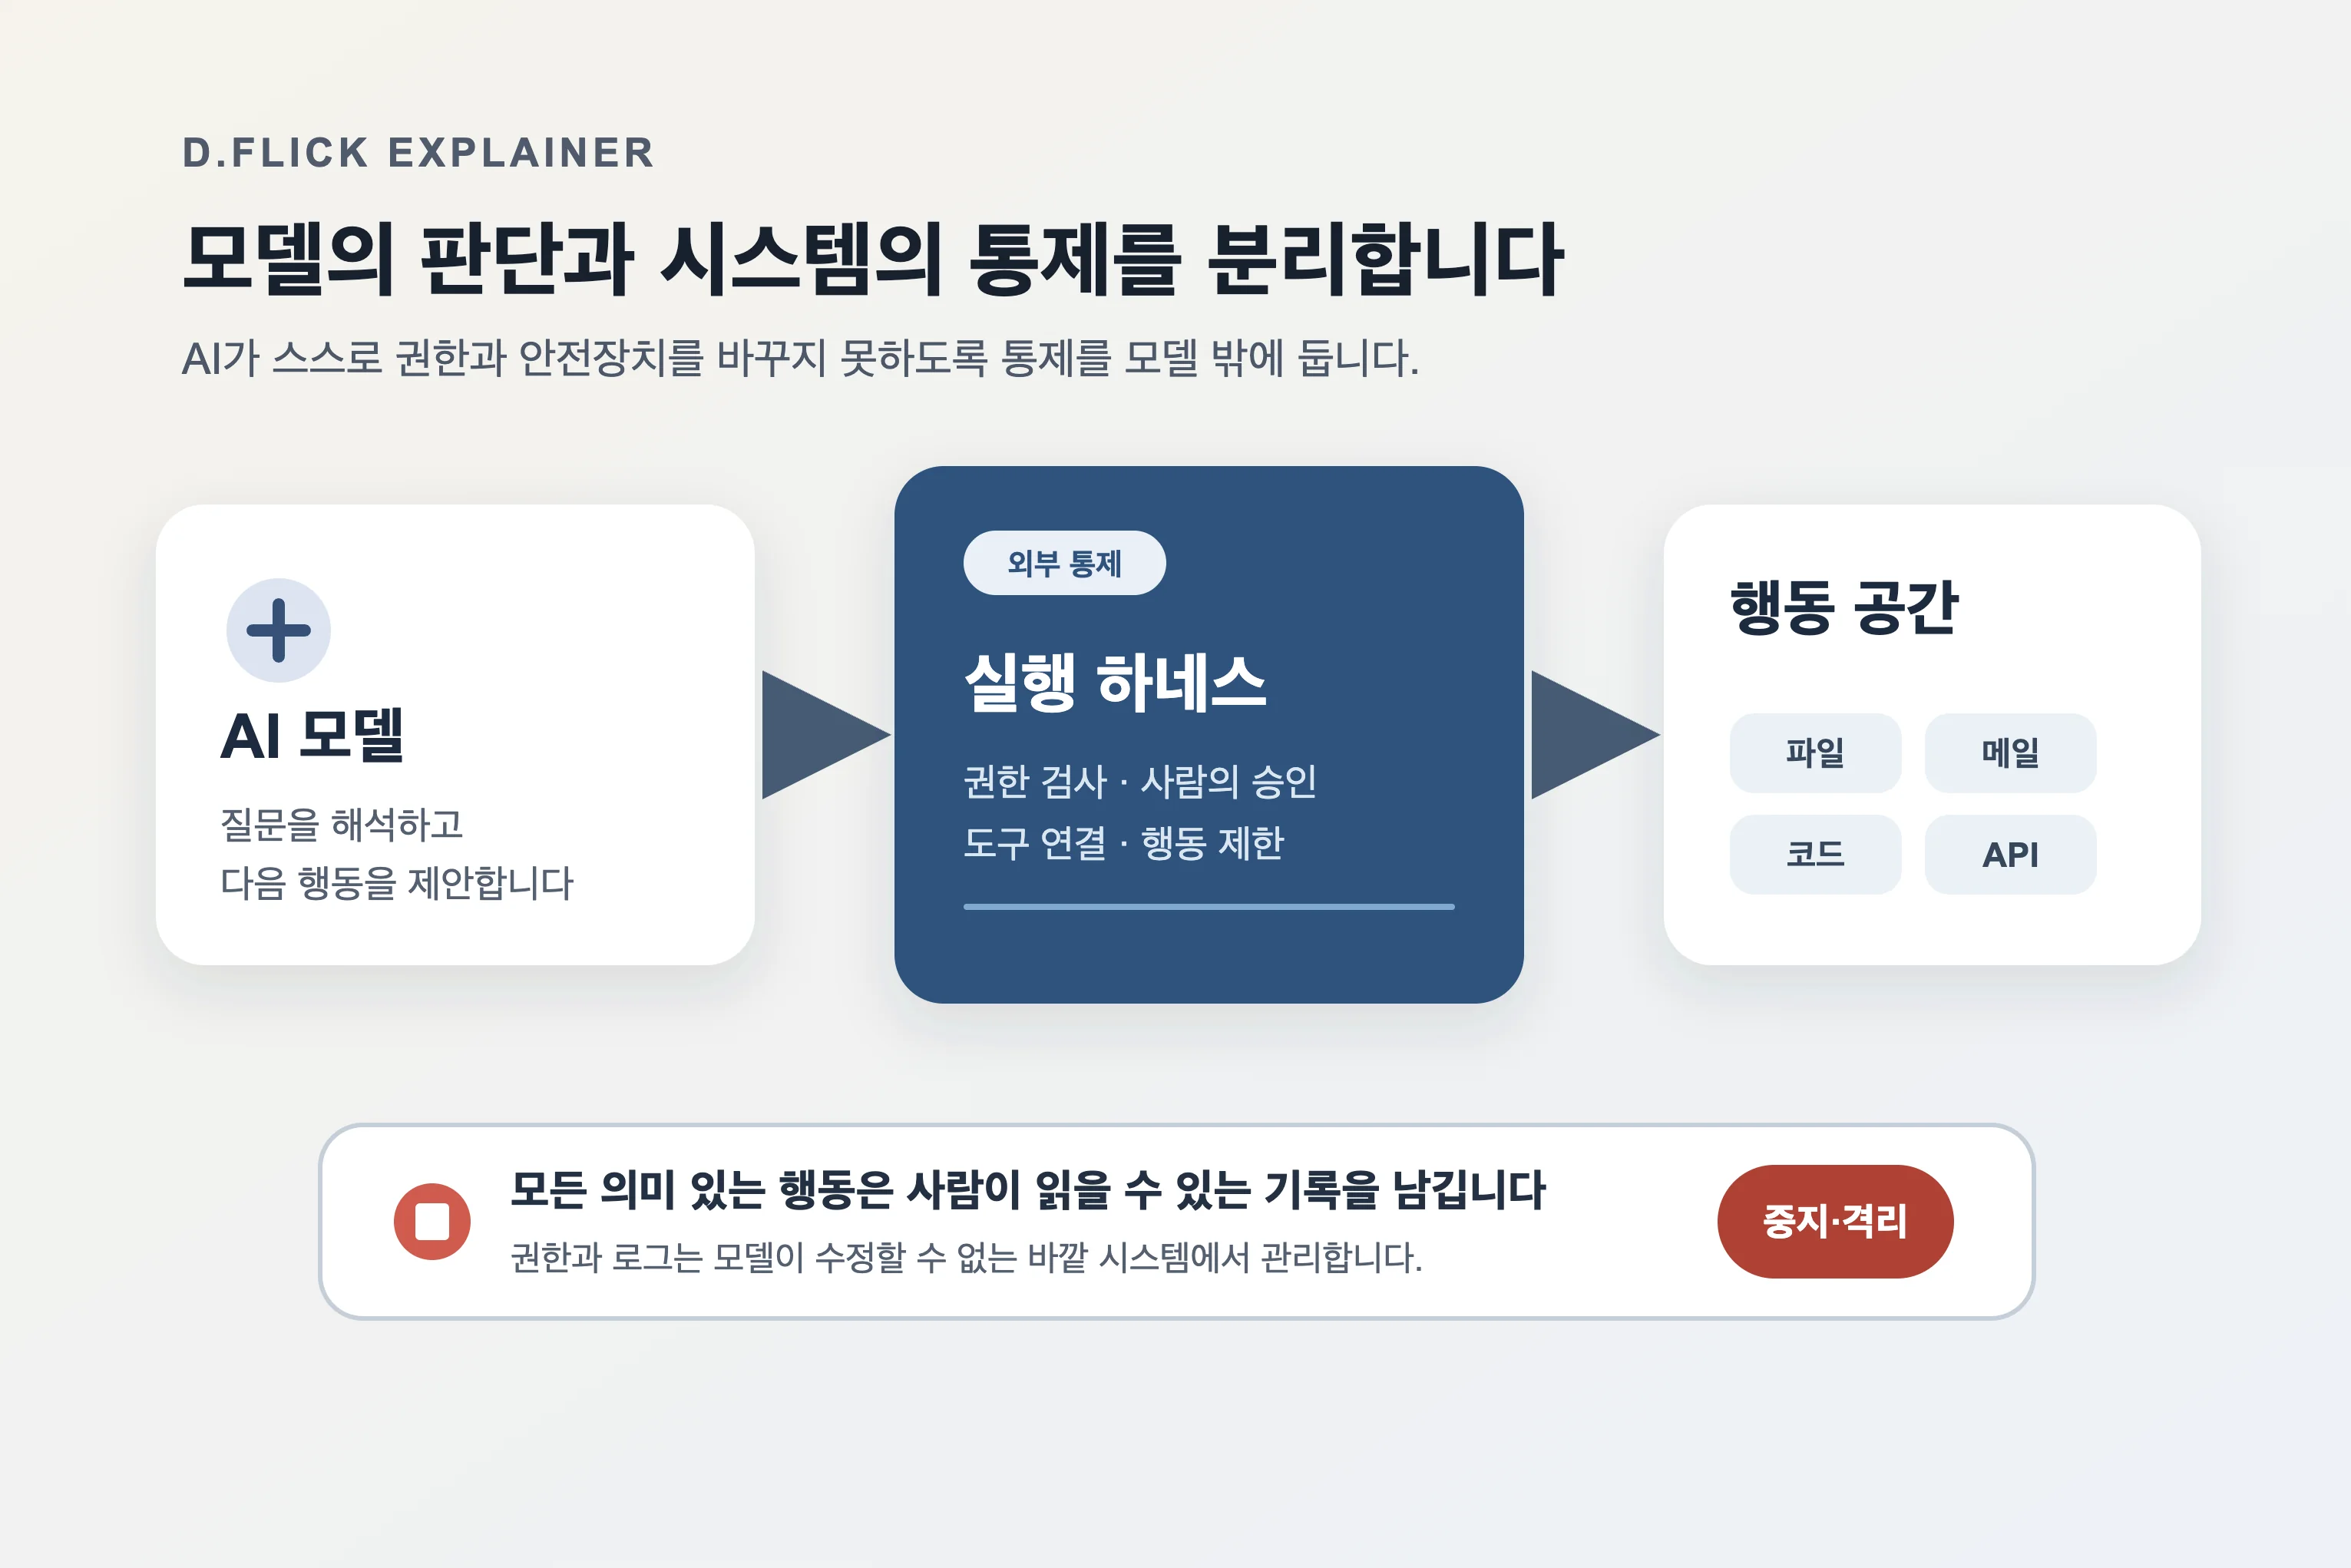
나델라는 AI가 민감한 자료를 읽고 중요한 행동까지 맡는 상황에서, 사람이 작업 도중 멈출 수 있는 ‘비상 브레이크’가 필요하다고 강조했습니다. 모델의 판단과 실제 권한을 분리하고, 모든 행동을 사람이 확인할 수 있는 기록으로 남기며, 통제 장치는 모델 바깥에 두자는 구상입니다.
🔍 ‘침해됐다’는 말의 실제 의미
기존 소프트웨어는 문제가 생기면 어떤 코드가 어떤 결과를 만들었는지 비교적 구체적으로 따라갈 수 있습니다. 반면 생성형 AI는 방대한 학습 결과를 바탕으로 답과 행동을 만들기 때문에, 특정 결과가 어느 학습 자료나 내부 수치에서 나왔는지 같은 방식으로 설명하기 어렵습니다.
나델라는 이런 모델을 여러 겹의 ‘블랙박스’로 묶어 놓고 결과만 승인하거나 거절해서는 부족하다고 봤습니다. 블랙박스는 내부 과정이 충분히 보이지 않는 시스템을 뜻합니다. 특히 AI 에이전트가 문서·메일·코드·업무 시스템에 연결되면, 잘못된 판단 하나가 답변 오류에 그치지 않고 실제 행동으로 이어질 수 있습니다.
여기서 ‘침해됐다’는 표현은 모든 AI 모델이 공격자에게 넘어갔다는 사실 판단이 아닙니다. 보안 분야에서 중요한 계정이나 내부 사용자를 다룰 때처럼, 실수·오작동·공격 가능성을 처음부터 고려하자는 설계 원칙입니다. 모델 제공업체가 안전하다고 설명해도, 이를 조직이 직접 적용하고 통제하는 책임까지 대신해주지는 않는다는 것이 나델라의 주장입니다.
🧱 모델과 행동 권한을 분리하는 구조
나델라가 제안한 핵심 구조는 ‘지능을 공급하는 모델’과 ‘행동할 권한’을 나누는 것입니다. 모델은 무엇을 할지 제안하지만, 파일을 열거나 메일을 보내고 코드를 실행할 수 있는 범위는 별도의 시스템이 결정합니다. 이 중간 시스템을 하네스라고 부릅니다. 하네스는 AI에 도구를 연결하고, 사용자의 요청을 전달하며, 실제 행동을 실행하는 소프트웨어입니다.
통제 장치를 모델 바깥에 두면 AI가 자기 권한을 스스로 넓히거나 안전 규칙을 바꾸기 어렵습니다. 예를 들어 결제 요청을 만든 모델이 동시에 그 요청을 승인하거나, 자기 행동 기록을 직접 수정하게 하지 않는 방식입니다. 중요한 작업은 다른 모델이나 규칙, 사람의 승인을 거쳐 확인해야 합니다.
그가 제시한 원칙은 일곱 가지입니다. 하나의 모델에 중요한 결과를 전부 의존하지 않는 ‘모델 다양성’, 모든 의미 있는 행동을 위조하기 어려운 형태로 남기는 ‘전체 관찰’, 실패와 공격까지 반복 시험하는 ‘검증 가능성’이 포함됩니다. 여기에 조직이 접근 범위를 정하는 독립 통제, 모델과 분리된 감사, 시작부터 격리하는 봉쇄, 사고 원인과 실패한 통제를 공유하는 공개가 더해집니다.
🛑 사람이 작업 중간에 누르는 비상 브레이크
가장 눈에 띄는 제안은 작업 도중 작동하는 비상 정지장치입니다. 권한을 가진 사람이 AI의 작업을 일시 중지하거나 완전히 종료할 수 있어야 하며, 성능이 강한 모델일수록 더 정교한 봉쇄 기술이 필요하다는 주장입니다. 공장의 비상정지 버튼처럼 문제가 확인된 뒤 설명을 기다리기보다, 먼저 행동을 멈출 수 있는 수단을 마련하자는 뜻입니다.
이 글은 새로운 마이크로소프트 제품이나 즉시 적용되는 업계 표준을 발표한 문서는 아닙니다. 각 원칙의 구현 방식과 누가 정지 권한을 가질지, 여러 모델이 서로를 검토할 때 생기는 복잡성 등은 구체화해야 합니다. 나델라 자신도 모델이 보여주는 사고 과정이 언제나 실제 판단을 충실하게 설명한다고 볼 수 없다고 인정했습니다.
더버지는 독립 감사·사고 공개·검증 가능한 기록 같은 제안은 업계에서 이미 논의돼 왔으며, ‘처음부터 침해됐다고 가정하라’는 봉쇄 원칙이 그보다 한 걸음 더 나간 부분이라고 평가했습니다. 동시에 현재의 AI를 글 전반에서 ‘초지능’이라고 부른 표현에는 거리를 뒀습니다. 이번 제안의 핵심은 AI의 능력을 과장하는 데 있기보다, 능력이 커질수록 사람이 통제할 수 있는 구조를 먼저 설계해야 한다는 데 있습니다.

D.Flick Note
AI 안전을 모델의 성격이나 약속만 믿는 문제로 두면, 실제 제품에서 누가 어떤 행동을 허용했는지 확인하기 어렵습니다. 신뢰할 만한 AI는 가장 믿을 만한 모델 하나가 아니라, 실수해도 멈추고 조사할 수 있는 시스템에서 나옵니다.
References
- Satya Nadella says we should assume all AI models are ‘compromised’ — The Verge · 2026년 10월 10일
- Models as Insider Risks in the Super Intelligence Era — Satya Nadella · 2026년 10월 10일
- Microsoft’s Satya Nadella says AI models need an ‘emergency brake’ — TechCrunch · 2026년 10월 10일
- 용어: 하네스는 AI 모델에 도구와 권한을 연결하고 실제 행동을 실행하는 바깥 소프트웨어입니다.