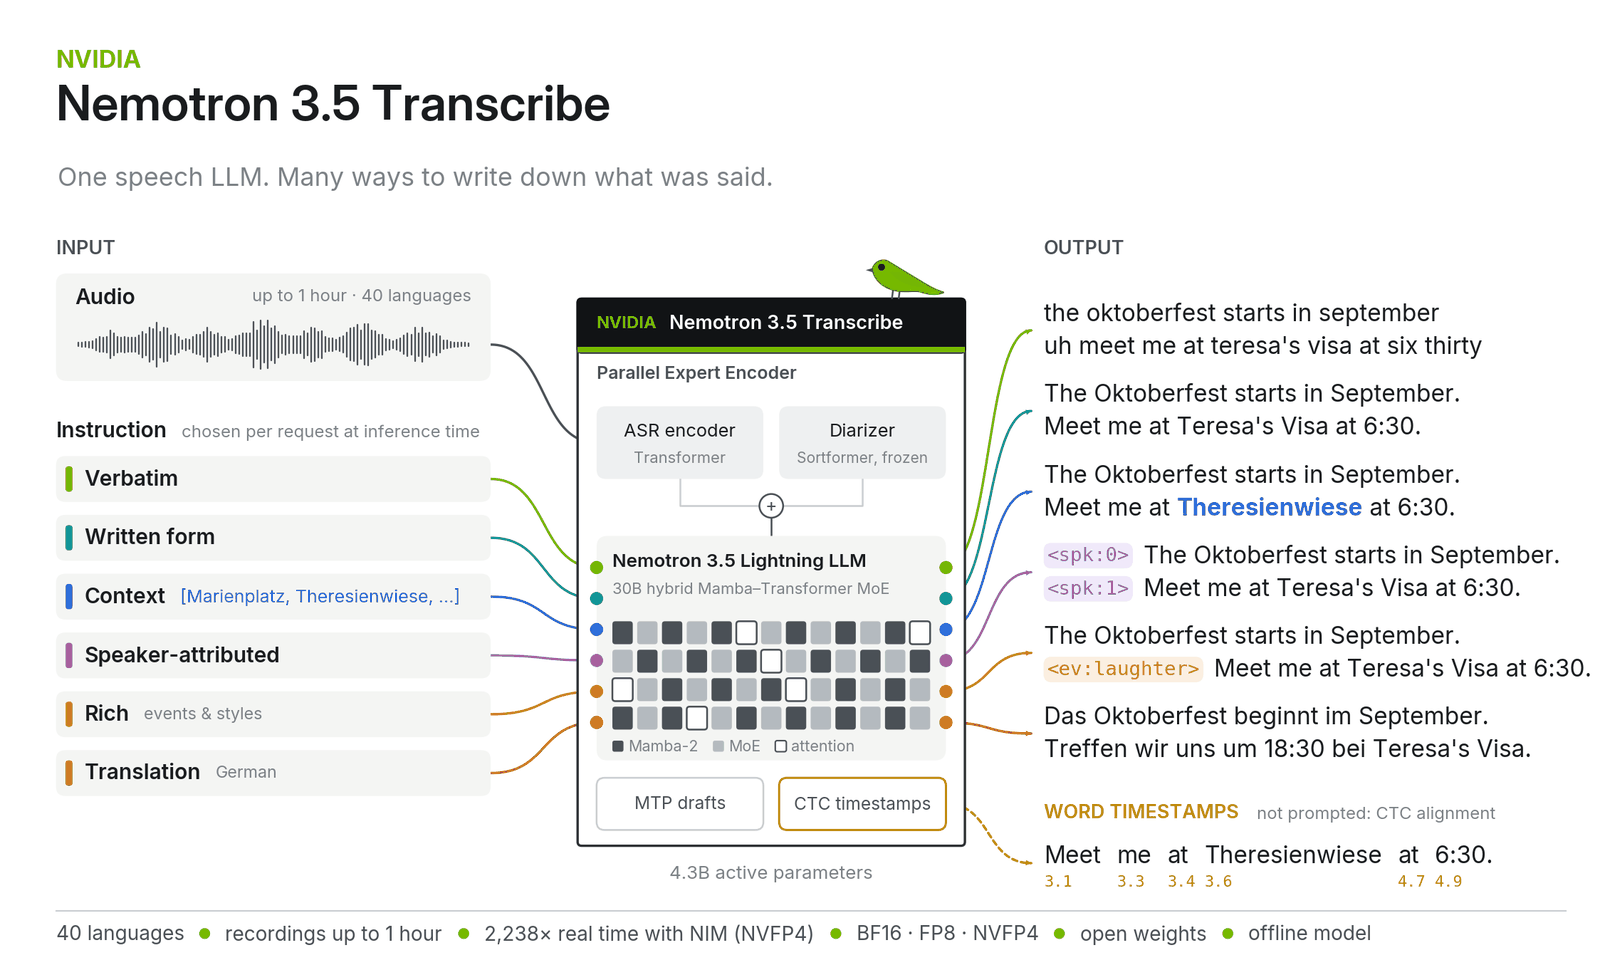
엔비디아가 녹음 내용을 받아 적는 일을 넘어, 화자 구분과 문장 정리, 번역까지 한 모델에서 처리하는 ‘Nemotron 3.5 Transcribe’를 공개했습니다. 자연어로 원하는 기록 방식을 지시하면 같은 음성을 회의록·자막·원문 기록에 맞게 다르게 정리할 수 있습니다.
모델 가중치*와 학습 도구가 공개돼 기업이나 연구자가 자체 서버에서 시험할 수 있습니다. 40개 언어와 최대 한 시간 길이의 음성을 지원하며, 단어별 시간 정보와 화자 표시도 함께 제공합니다.
🎙️ 받아쓰기 방식도 문장으로 지시합니다
기존 음성 인식 도구는 말을 글자로 바꾼 뒤, 별도의 프로그램으로 화자를 나누거나 문장을 다듬는 경우가 많았습니다. Nemotron 3.5 Transcribe는 음성과 자연어 지시를 함께 받아 한 번에 여러 형태의 결과를 만듭니다. 예를 들어 ‘말버릇과 반복을 그대로 남겨 달라’거나 ‘읽기 쉬운 문장으로 정리하고 화자를 구분해 달라’고 요청할 수 있습니다.
또한 제품명이나 사람 이름처럼 일반 음성 인식이 자주 틀리는 단어를 맥락으로 알려줄 수 있습니다. 회의 참석자 명단이나 전문 용어 목록을 미리 주면 해당 표현을 더 정확히 기록하는 방식입니다. 누가 언제 무엇을 말했는지 필요한 정보까지 한 모델이 함께 내보낸다는 점이 핵심입니다.
결과 형식을 바꾸기 위해 별도의 모델을 여러 번 거칠 필요도 줄어듭니다. 인터뷰 원문을 보존할 때는 말의 반복과 망설임을 남기고, 회의록을 만들 때는 같은 음성에서 문장 부호와 숫자 표기를 정리할 수 있습니다. 방송 자막에는 시간 정보를 붙이고, 다국어 회의에는 언어 판별과 번역을 함께 요청하는 식입니다. 모든 단계를 완벽히 처리하지는 못해도, 여러 도구를 오가던 기록 과정을 한 흐름으로 묶습니다.
🌍 40개 언어와 여러 기록 형태를 지원합니다
모델은 40개 언어를 자동으로 구분합니다. 같은 녹음에서 말버릇을 그대로 남긴 ‘원문형’, 군더더기를 덜어낸 ‘문서형’, 다른 언어로 옮긴 번역본을 만들 수 있습니다. 최대 한 시간 분량을 처리하며 단어별 시작·종료 시간도 함께 내보냅니다.
엔비디아가 공개한 평가에서는 영어와 다국어 음성 인식 오류율이 각각 평균 4.71%, 4.62%로 제시됐습니다. 사람 이름 같은 맥락 단어의 오류는 비교 기준보다 최대 6분의 1 수준으로 줄었다고 설명합니다. 이 수치는 엔비디아가 정한 데이터와 조건에서 나온 결과입니다. 실제 회의실의 소음과 억양, 겹쳐 말하는 상황에서는 별도 확인이 필요합니다.
단어별 시간 정보는 자막 편집에서 바로 쓸 수 있고, 화자 표시는 회의록의 발언자를 나누는 데 쓰입니다. 받아쓰기 정확도와 함께 이 부가 정보가 맞아야 후속 편집을 줄일 수 있습니다.
중요한 고유명사 하나가 틀리면 낮은 평균 오류율도 소용이 없습니다. 엔비디아는 참석자 이름과 전문 용어를 미리 입력해 이런 오류를 줄이도록 했습니다. 다만 배경 소음이 크거나 여러 사람이 겹쳐 말하면 화자 구분과 시간 표시는 흔들릴 수 있습니다.
🧩 공개 모델이라 기록 환경을 직접 구성할 수 있습니다
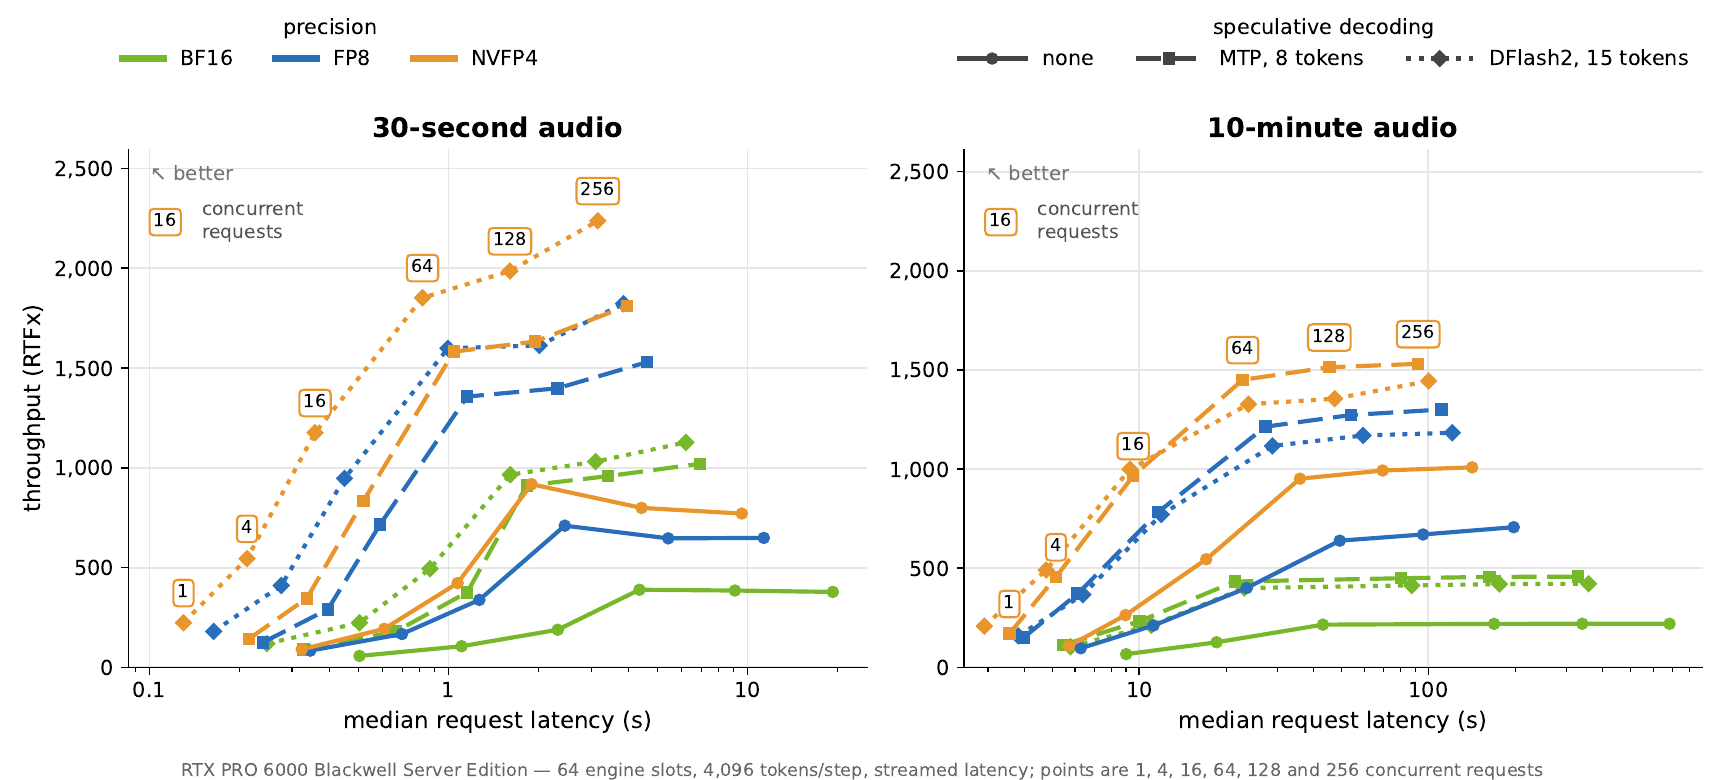
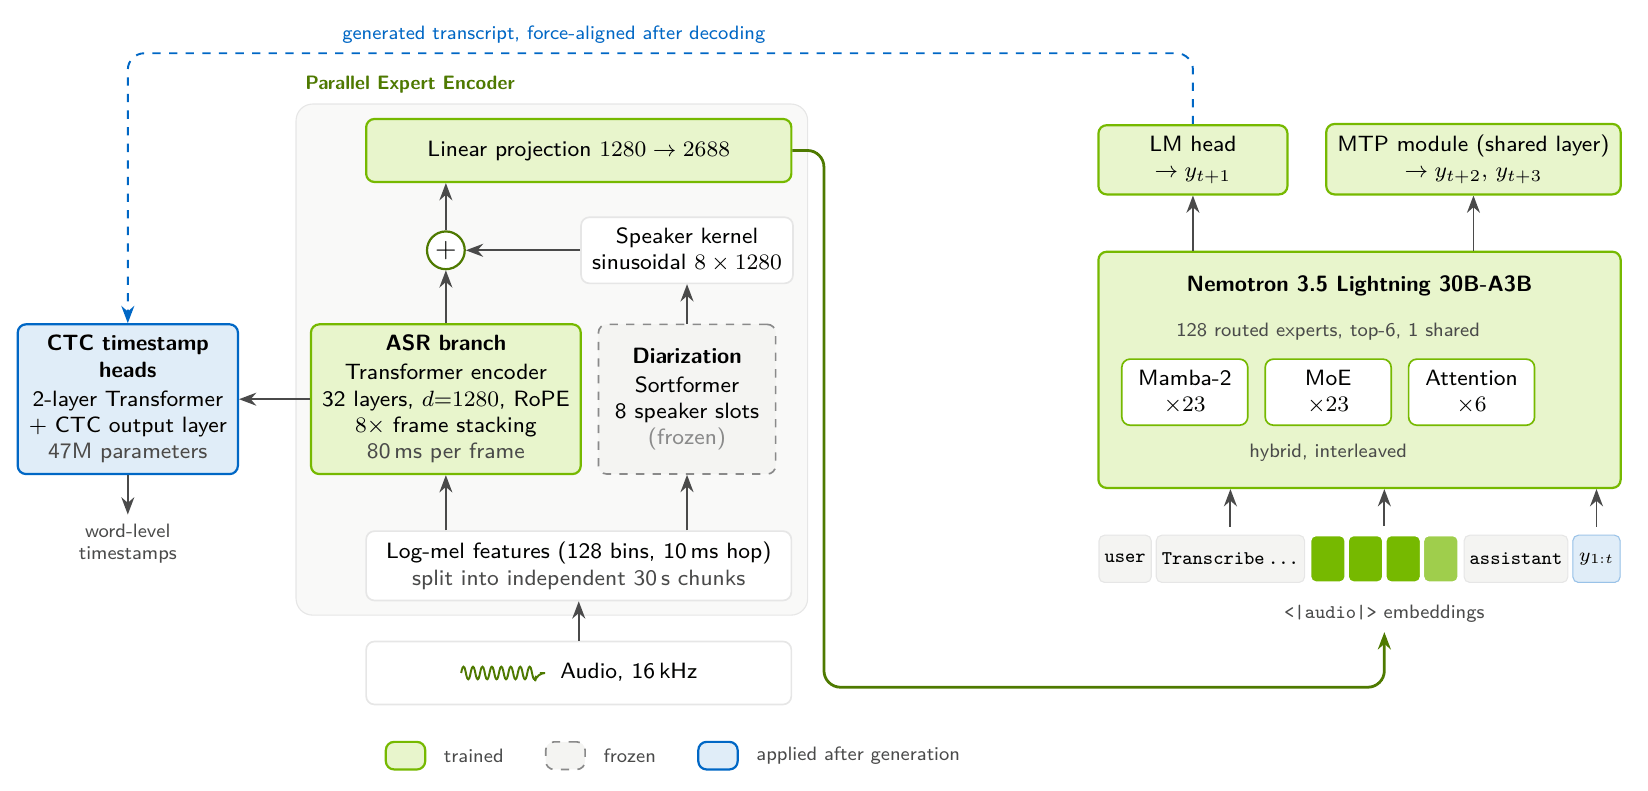
Nemotron 3.5 Transcribe는 약 43억 개의 활성 매개변수를 사용합니다. 엔비디아는 RTX PRO 6000 Blackwell 한 장에서 1초 동안 최대 2,238초 분량의 음성을 처리했다고 밝혔습니다. 이 역시 회사가 공개한 특정 하드웨어와 설정의 측정값입니다.
모델 파일과 학습 데이터 구성 도구인 OpenMDW 1.1, NeMo Speech 툴킷이 함께 공개됐습니다. 조직은 외부 서비스에 녹음을 보내지 않고 자체 환경에서 모델을 운영하거나, 필요한 용어와 언어에 맞춰 추가 학습을 시도할 수 있습니다. 다만 화자 식별과 번역 품질은 언어와 녹음 조건에 따라 달라질 수 있어, 중요한 기록은 사람이 다시 확인해야 합니다.
자체 서버에서 돌리면 민감한 녹음을 외부 서비스에 보내지 않아도 됩니다. 대신 장비와 관리 인력이 필요하고, 녹음 접근 권한과 보관 기간, 당사자 동의는 운영 주체가 직접 정해야 합니다. 공개 모델은 운영 장소를 선택하게 해 줄 뿐 개인정보 책임까지 맡지는 않습니다.

D.Flick Note
Nemotron 3.5 Transcribe는 받아쓰기 뒤에 따로 하던 화자 구분과 문장 정리, 번역을 한 모델에 묶었습니다. 같은 녹음을 회의록·자막·원문 보존용으로 각각 가공하는 과정이 짧아집니다.
References
- NVIDIA Nemotron 3.5 Transcribe · NVIDIA Research · 2026.10.28
- Granary-v2 · NVIDIA Research · 2026.10.28
- 화자 분리*: 하나의 녹음에서 서로 다른 사람이 말한 구간을 구분해 표시하는 기능입니다.
- 모델 가중치*: AI가 학습하면서 얻은 수치 묶음으로, 공개되면 이용자가 자체 환경에서 모델을 실행하거나 조정할 수 있습니다.